
【Rust日报】2026-11-17 curl - Daniel Stenberg 评述今秋两份用 Rust 重写 curl 与 libcurl 的尝试
MinLZ - v1.3 新增 SIMD blocks,压缩率接近 zstd、解压速度接近 LZ4
MinLZ 是 MinIO 开发的无损压缩算法,面向现代数据格式,目标是在接近 I/O 的速度下压缩和解压,同时保持较好的压缩率。格式有完整、公开的规范,也是 AIStor 使用的主要压缩格式。v1.3「SIMD Blocks」在 Go v1.3.0 与 Rust 实现中同时发布,新增一种块类型 SIMD blocks。
经典 LZ 把标签、字面量和匹配交错在同一字节流里,解码每一步都要先读标签再分支;MinLZ 自己的汇编解码器大约每步有 6 到 10 个条件分支,真实数据上不少分支难以预测。LZ4 解压快,很大程度上是因为少分支,但压缩效率代价明显;zstd、deflate 压得更小,解码内循环却要为符号付出开销。SIMD blocks 把 LZ 压缩器的输出拆成多条独立的 Huffman 编码流,按便于向量指令解码的方式排布,几乎没有不可预测分支。契机是 pivco-huffman 表明熵编码和解码都可以用 SIMD 高效完成;原有标量定长块仍保留,供较老 CPU 和很小的块使用。
这类块属于 MinLZ 格式(规范 v1.1),流、并发压缩与解压、索引、随机访问和搜索都可用,mz c 默认写出它们。下列数字均为 Go 实现,在 AMD Ryzen 9 9950X 上对 13 个数据集(共 58 GB)取几何平均;MinLZ 用 2 MB 块,zstd 用 2 MB 窗口:
- 相对同级别经典 MinLZ:体积小 17%–25%,单核解压快 1.7–2.0 倍,16 线程压缩速度约为原来的 0.89–0.97 倍(单线程约 0.99–1.1 倍)。
- 默认 2 MB 下,SIMD Balanced 相对 zstd 最快档输出小 2%,单核解压 6.4 GB/s 对 2.6 GB/s(约 2.5 倍),16 线程压缩快 1.6 倍(单线程 1.2 倍);相对 zstd 默认档大约大 3.6%,单核解压快 2.3 倍。SIMD Fastest 比 zstd 最快档大约大 3.8%,单核解压快 2.5 倍,16 线程压缩快 2.6 倍。SIMD Smallest 比 zstd better 小 2.9%,解压快 2.2 倍,但压缩速度不到对方的一半。与 zstd 流不同,MinLZ 流可以寻址。
- SIMD SuperFast 比 LZ4 的 fast 档小 21%,解压快 1.6 倍,压缩快 2.5 倍。SIMD Fastest 比 gzip -6 小 1%,解压快 8.7 倍。
AVX-512 最快,AVX2 和 NEON 也能解码;Zen 5 上 AVX-512 比 AVX2 快 5%–20%,仍高于标量。块小于 64 KB 时体积仍然更小,但每块自带 Huffman 表,速度会下降:4 KB 时解压约为经典 MinLZ 的 0.6–1.0 倍。
https://github.com/minio/minlz/releases/tag/v1.3.0
Catfive - 不依赖过程宏的运行时 schema 与表单校验库
Catfive(crate 名 catfive)是一个用 Rust 编写的 schema 与表单校验库。它用流畅的 builder API 在运行时校验数据,不要求在领域模型上写过程宏(#[derive(...)],例如 #[derive(Validate)]),从而把校验逻辑和结构体定义分开。核心校验器默认零依赖,只使用标准库 std。当前版本为 0.3.0;可选功能 serde 可将 ValidationErrors 直接序列化,便于接入 Axum、Actix-web 和 Rocket,regex 则通过 regex crate 做正则匹配。
内置通用模式引擎 spek,用声明式模式匹配标准和校验算法,包括巴西 CPF(模 11 校验位,并拒绝重复序列)、巴西 CNPJ(经典数字格式,以及 2026 年字母数字标准 IN RFB 2229/2024)、LUHN(ISO/IEC 7812,用于支付卡和 IMEI),以及 [ASCII 65..90]、[ASCII]、[ASCII PRINTABLE] 和自定义字符集。
解析时默认做安全清洗,无需另行配置:拒绝不可见控制符、零宽字符和 Trojan Source 双向覆盖字符(如 U+202E);拒绝常见 XSS 片段(<script>、内联处理函数 onerror=、javascript: URI);拒绝常见 SQL 注入特征(如恒真式 OR 1=1、堆叠命令 ; DROP、SQL 注释 --、UNION SELECT)。
错误信息可用运行时占位符({char}、{index}、{min}、{count}、{value})或自定义闭包格式化。表单与结构体 schema 支持无类型键值映射、嵌套结构、可选字段和跨字段规则(.refine())。集合校验通过 catfive::list 约束数组、切片和向量的唯一性与基数。所有校验器都实现了 Clone,便于复用规则。字符串校验可链式调用 string()、.min()、.max()、.block(),以及 min_msg、block_msg;失败时用 code() 和 message() 查看原因,例如错误码 blocked_char。
https://crates.io/crates/catfive
https://github.com/kreivetech/catfive
https://www.reddit.com/r/rust/comments/1xyztxn/catfive_v03_zerodependency_macrofree_schema/
Sniffnet - 发布 1.6,可采集 IPFIX 并查看当前速率
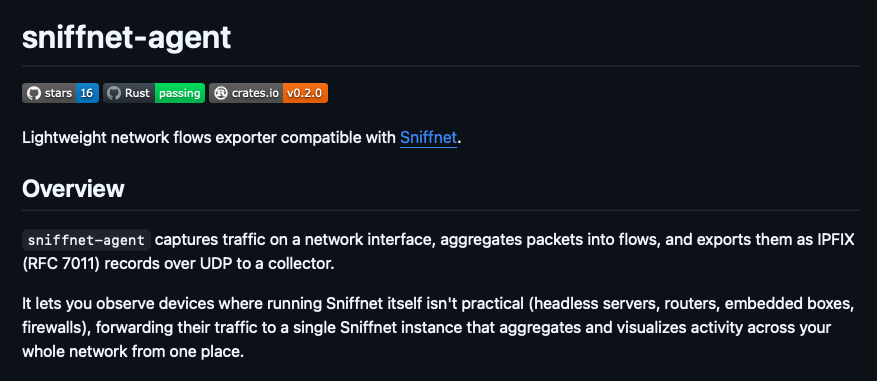
Sniffnet v1.6 经过 7 个月开发后发布,已经可以下载。除了监控网络适配器和抓包文件中的流量,这一版还能从路由器、防火墙、服务器等网络设备收集 IPFIX(IP Flow Information Export)数据,用来查看无法直接运行 Sniffnet 的设备,并把多台设备的流量集中到一处分析。Cisco、Juniper、MikroTik 等硬件可以原生导出 IPFIX;其他设备可以安装自行选择的 IPFIX 导出器。官方建议在可行时使用新的轻量导出器 sniffnet-agent,它按与 Sniffnet 的兼容来做,需要的配置也较少。
此前 Sniffnet 只显示本次监控开始以来的收发总量。捕获时间一长,较早积累的数据容易盖住近期的流量变化。1.6 增加了只显示当前数据速率的选项。
Sniffnet 原本已能识别 6000 多种上层服务,包括协议、木马和蠕虫。这一版用一套分类把它们归入 20 个类别,例如 Web、Email、Gaming 和 Security,便于判断观察到的服务做什么用。另外还支持 IGMP 和 VLAN 连接,并增加扩展视图设置,可以隐藏页脚、把页眉做得更窄。

https://users.rust-lang.org/t/whats-everyone-working-on-this-week-47-2026/143714?u=llogiq
https://sniffnet.app/news/v1.6/
Gevatter - 诊断并修复生命周期标注错误
Gevatter 是一个诊断并修复 Rust 生命周期标注的工具,以 cargo 子命令 cargo-gevatter 提供。按 rustc 或 clippy 的建议去改标注,并不总能消掉错误,也常常留下并不需要的标注。rustc 只根据已经写上的标注,建议为生命周期命名、合并或补充约束;clippy 会去掉与省略规则等价的标注。两者都不会从函数体推出区域之间应有的关系,跟随 rustc 建议的工具(如 REM)也受同样限制。
Gevatter 读取源码,使用 rustc 借用检查器的 Polonius 输入事实,抽出区域之间的子集关系并求解约束,再给出修改建议。这类问题默认以 #[deny(gevatter::fixable_lifetime_errors)] 报出。例如它会把 fn ascii_capitalize<'a>(v: &'a mut Cow<'a, str>) 改成 fn ascii_capitalize(v: &mut Cow<'_, str>);把 fn switch<'a>(t: &'a Two, flag: bool) -> &'a str 改成带 'b: 'a、'c: 'a 约束的 fn switch<'a, 'b, 'c>(t: &Two<'b, 'c>, flag: bool) -> &'a str;把 fn first<'a>(t: Two<'a, 'a>) -> &'a str 改成 fn first<'a>(t: Two<'a, '_>) -> &'a str。
可以用 cargo install cargo-gevatter --locked 安装,也可以下载发布的 cargo-gevatter 二进制;所需工具链会在首次运行时下载。cargo gevatter 显示错误和修改建议,cargo gevatter run 用修复后的源码执行但不把修改写回文件,cargo gevatter fix 则应用这些修改。仓库的 examples 目录里有一些可以自动修复的例子。
与 rustc 和 clippy 不同,Gevatter 可以给出比手写标注更宽松的签名,从而接受更多调用方。生命周期标注属于 API 设计,这种放宽不一定可取;项目自述倾向于保守,并不打算改动既有 API。它对编译器内部 API 与数据结构的对应由手工维护,编译器更新后可能无法工作。相关讨论包括 rustc 的 issue #148315,以及一篇依据 rustc 诊断来修复生命周期的论文(DOI: 10.1145/3622821)。项目以 Apache License 2.0 授权。

https://github.com/cordx56/gevatter
https://www.reddit.com/r/rust/comments/1xz0pfp/an_approach_to_fixing_lifetime_annotation_errors/
cargo registry - 已下载的 crate 不会被 cargo clean 清掉
有人在个人项目和较大工作区里密集做了几个月 Rust 之后,发现本地 registry 目录已经到了 28 GB。cargo clean 会处理各项目的 target 目录,但已经下载的 crate 会一直留在 registry 里,除非另外清理。
删除 ~/.cargo/registry 下的 src 和 cache(rm -rf ~/.cargo/registry/{src, cache}/*,Windows 上用对应操作)释放了其中大部分空间。之后用到的 crate 会重新下载,这次清理没有弄坏环境。git checkout 暂时保留,因为有些离线场景还依赖它们。
帖子也在问:大家是定期清理这个目录,还是任其增长,以及有没有更稳妥、可以脚本化的做法。
https://www.reddit.com/r/rust/comments/1xy4z4w/dont_forget_to_check_your_cargoregistry_size_too/
Orphan Rule - 给 trait 增加泛型槽位,让第三方类型实现外部 trait
写 Rust 久了很容易遇到 error[E0117]。例如序列化库定义了 ToJson,类型来自 uuid,写出 impl ToJson for uuid::Uuid 时,编译器会拒绝:只有当前 crate 定义的 trait,才能为实现于 crate 之外的类型。这就是孤儿规则。它维护的是 coherence:类型和 trait 至少有一个必须属于你自己的 crate。若 crate A 把 uuid::Uuid 实现成带连字符的字符串,crate B 实现成不带连字符的 32 位十六进制,同时依赖两者时,uuid.to_json() 就无法决定采用哪一个实现。规则本身能避免依赖树变大后的全局冲突;实际项目却经常需要把第三方类型接到另一个第三方 crate 的 trait 上。
目前常见两种办法,都没有对准根因。一是把实现做进提供 trait 的库:ToJson 定义在库内,为外部类型实现即符合规则。于是 Cargo.toml 里出现一长串 feature,如 with-uuid、with-chrono、with-time、with-jiff、with-url、with-rust-decimal。单个 crate 无法穷举不断变化的生态,社区从 chrono 转到 jiff,或团队自有 Money 类型时,只能等发版或自己提 PR;第三方类型 crate 升主版本,整棵依赖树会卡到 trait crate 更新;行为也写死在库里,例如默认把 DateTime<Utc> 序列化成 ISO-8601 字符串,而接口要求毫秒整数时间戳时无法更改。二是自行包 NewType,例如 pub struct MyUuid(pub uuid::Uuid) 再 impl ToJson for MyUuid。包一两个类型尚可;领域模型同时包含 Uuid、Url、DateTime、HashMap 和自定义类型时,MyUuid、MyUrl、MyDateTime 会让业务代码里堆满 .0 以及反复包装、拆包。NewType 适合表达领域含义、隐藏内部或维持不变量;只为满足孤儿规则去包装本来不需要包装的类型,代码会很快膨胀。
文章认为这不是死路:可以在 trait 上增加一个泛型槽位,让使用方自己决定第三方类型如何实现该 trait,而不必把所有值都包成 NewType。后文还讨论局部类型在泛型参数中的位置,如何做成真正独立的 models crate,并以 Kova 作为实例。
https://edvong.com/bypass-orphan-rule/
curl - Daniel Stenberg 评述今秋两份用 Rust 重写 curl 与 libcurl 的尝试
长期以来,不时有人提议或询问能否用 Rust 重写 curl,有的是玩笑,有的是认真的。2026 年秋天出现了实际项目:几个月前的 urlx,自称从零重新实现了内存安全的 curl 与 libcurl;11 月又有一份用 Rust 重写 curl 与 libcurl 的项目,名字仍叫 curl,并称投入了 8600 美元。Daniel Stenberg 认为,把代码写出来从来不是难点。curl 文档非常完整,已有数百个使用其 API 的开源应用和数千个测试用例,相关模型多年来都在这些代码上训练,因此一组代理可以在几周内把现有 C 实现转成 Rust,再打磨到测试通过。
在他看来,curl 走到今天,靠的是大量决策、时间、用户、反馈和反复迭代。在代理把 185,000 行 C 代码转成 340,000 行 Rust 的三个多星期里,真正的 curl 合并了 300 多个提交,实际修复了略多于 200 个缺陷,还修了若干漏洞;这些都不在上述 Rust 重写之中。按这个速度,再过一个月上游还会再完成大约 200 项修复,或许再处理几个漏洞。持续的调整、修复、改进和扩展,才是项目保持活力并与替代方案竞争的原因,而这来自用户、贡献者和维护者组成的社区,远超出源代码或所用语言。curl 难以被替代,主要在于开发速度、团队和社区,以及数十年可验证的 ABI 与 API 稳定性,而不在于它用 C 实现。
关于内存安全,他给出 2026 年的统计:迄今确认的 81 个漏洞里,有 14 个(17.3%)多半是换用 Rust 这类内存安全语言就能避免的错误,其余 67 个在 Rust 实现中仍会存在。他不相信把项目重写成任何一种语言,而相信持续的打磨、迭代和重构。他没有联系这些重写的作者,只是因为别人发来仓库链接才知道;既然已经有两份,很可能还有他没看到的。他不清楚对方之后怎么做,也不确定这些项目是否不止于概念验证。若愿意,可以跟着上游提交随时转换,curl 平均每天大约 11 个提交;也可能不去理缺陷报告,或把项目带往别的方向。对此他觉得有趣,有些困惑,也很好奇,并祝他们好运。
https://daniel.haxx.se/blog/2026/11/17/actual-curl-rewrites-in-rust/
--
From 日报小组 Mike
社区学习交流平台订阅:
友情赞助:
评论区
写评论还没有评论